DLQ: fronta stahování pro domácí server
Obsah článku
Na domácím serveru jsem roky používal JDownloader2. Běžel v Dockeru a jeho desktopové rozhraní jsem ovládal přes VNC v prohlížeči. Stahování fungovalo, ale ovládání mi postupně přestalo vyhovovat.
Při vkládání odkazů jsem řešil sdílení schránky mezi prohlížečem a vzdálenou plochou. Okno se nikdy pořádně nevešlo do prohlížeče a z telefonu se aplikace ovládala špatně. Přidávání odkazů z příkazového řádku navíc v mém tehdejším řešení znamenalo použít MyJDownloader a online účet. Chtěl jsem něco, co můžu ovládat přímo na vlastním serveru.
Tak vzniklo DLQ (Download Queue): služba, která spravuje frontu stahování, nabízí API a dá se ovládat z terminálu i z webu. Zároveň jsem získal praktický důvod naučit se Go a SvelteKit.
Kód a návod na zprovoznění jsou v repozitáři DLQ.
Jak jsem chtěl stahování používat
Většina mých požadavků vypadá podobně: přidat pár odkazů, vybrat složku, nechat server pracovat a později zkontrolovat výsledek. Když něco selže, chci zjistit proč a zkusit to znovu, aniž bych musel celou dávku sestavovat od začátku.
Kolem toho je DLQ postavené. Podporuje přímé odkazy HTTP/HTTPS, Webshare bez přihlášení a veřejné odkazy na soubory na MEGA. Záběr je záměrně úzký. DLQ nenabízí tolik integrací s úložišti jako JDownloader2 a neřeší captchu ani vyhledávání odkazů.
Po spuštění kontejneru a nastavení cílového adresáře vypadá běžné použití takto. Místo <url> patří odkaz ke stažení. Číslo 12 nahraďte ID úlohy, které vrátí DLQ:
# Přidání stahování do složky uvnitř kontejneru
docker exec -it dlq dlq add "<url>" --out /data/downloads

# Průběžné sledování fronty
docker exec -it dlq dlq status --watch

# Poslední události úlohy 12
docker exec -it dlq dlq logs 12 --tail 80

# Opakování úlohy po prozkoumání chyby
docker exec -it dlq dlq retry 12
Celou dávku lze načíst ze standardního vstupu, jeden odkaz na řádek. Soubor urls.txt je v tomto příkladu na počítači, ze kterého spouštíte příkaz Dockeru:
docker exec -i dlq dlq add --stdin --out /data/downloads < urls.txtPřepínač -i předá obsah souboru do kontejneru. Není potřeba interaktivní terminál, takže se tento způsob hodí i do skriptů.

Která část co dělá
Základem je dlqd, služba napsaná v Go s HTTP API standardně na portu 8099. Nástroj dlq pro příkazový řádek je klientem tohoto API. Volitelné webové rozhraní ve SvelteKitu běží samostatně na portu 8098 a jeho serverová část předává požadavky hlavní službě.
O přípravu a stahování souborů se starají tři hlavní části:
- Resolver z podporovaného odkazu získá údaje potřebné ke stažení. U přímého HTTP odkazu nemusí dělat skoro nic, u odkazu na úložiště může být potřeba nejprve získat dočasnou adresu souboru.
- Fronta ukládá úlohy do SQLite a spravuje jejich stav, pokusy a události.
- aria2 přenáší soubor a přes JSON-RPC hlásí průběh.
Prohlížeč -> webové rozhraní (:8098) -> dlqd API (:8099) <- dlq CLI
                                         |
                                         +-- SQLite: úlohy a události
                                         +-- resolvery: příprava odkazů
                                         +-- aria2: přenos souborů
                                         +-- dešifrování a rozbalování
Nástroj aria2 jsem vybral proto, že spolehlivý přenos souborů je sám o sobě poměrně velký problém. Umí hlásit průběh, stahovat souběžně a navazovat na přerušené přenosy. DLQ kolem toho doplňuje věci, které jsem potřeboval: trvalou frontu, chování podle konkrétní služby, výběr cíle a dost záznamů k dohledání příčiny chyby.
Úloha ve frontě přežije jednotlivý přenos
Úloha je víc než odkaz. DLQ ukládá její stav, počet pokusů, cílový adresář, název souboru, údaje od resolveru a události. Hodí se to ve chvíli, kdy vypadne spojení nebo úložiště vrátí dočasnou chybu. I po neúspěšném přenosu zůstává ve frontě konkrétní úloha, kterou lze prohlédnout a spustit znovu.
Běžný průchod je queued → resolving → downloading → completed: čekání ve frontě, příprava odkazu, stahování a dokončení. Úloha může být také pozastavena, může selhat nebo přejít do stavu decrypting pro následné zpracování. Chyba v této poslední fázi má vlastní stav decrypt_failed. Úspěšně stažený archiv tak nevypadá jako hotový výsledek, pokud se ho nepodařilo rozbalit.
Aby se fronta skutečně zachovala, je potřeba správně nastavit úložiště. Databáze standardně leží v /state/dlq.db, takže adresář /state musí být připojený jako trvalý svazek Dockeru nebo adresář z hostitele. Vlastní trvalé umístění potřebují také stažené soubory, obvykle v /data. Pokud zachováte jen soubory, při nahrazení kontejneru ztratíte historii fronty. Samotná databáze zase neuchová stažený obsah.
Trvalá fronta také nezaručuje, že každý přenos půjde obnovit přesně od posledního bajtu. To záleží na úložišti a konkrétním odkazu. U Webshare se pozastavení a obnovení chová spíš jako zastavení a nový pokus: získat čerstvý odkaz může být užitečnější než držet se neplatných údajů o předchozím přenosu.
Chyby, podle kterých se dá rozhodnout
Resolvery vracejí konkrétní chybové kódy. Díky nim se lépe pozná, zda má smysl zkusit přenos znovu, nebo mu za současných podmínek něco brání:
| Chyba | Význam |
|---|---|
login_required | Úložiště pro tento požadavek vyžaduje přihlášení |
quota_exceeded | Podle úložiště byl vyčerpán limit stahování |
captcha_needed | Úložiště vyžaduje vyřešení captchy |
temporarily_unavailable | Soubor nebo služba jsou dočasně nedostupné |
unknown_site | Výslovně zvolený resolver není rozpoznán |
Kódy vysvětlují překážku, ale neodstraňují ji. Pokud úložiště vyžaduje přihlášení nebo vyřešení captchy, anonymní resolver si s tím neporadí ani při opakovaném pokusu. Než se rozhodnu stahování zopakovat, můžu se podívat na události konkrétní úlohy.
Stejně přehledné musí být i následné zpracování. DLQ umí po stažení archivy dešifrovat nebo rozbalit, přijmout heslo k archivu pro celou dávku a maskovat citlivé hodnoty v záznamech. Soubory z MEGA mají vlastní krok dešifrování s ověřením integrity. Ten je oddělený od rozbalování archivu chráněného heslem.
Další komplikací jsou vícedílné archivy: jeden celek může tvořit mnoho souborů. DLQ seskupuje sady .partNN.rar i starší .rar / .r00, takže je můžu znovu spustit nebo odstranit společně. Odpovídá to tomu, jak o archivu přemýšlím, a nemusím ručně spravovat každý díl.
Cílové složky a webové rozhraní
Cíl jako /data/downloads je cesta uvnitř kontejneru. To, kde budou data na hostiteli skutečně ležet, určuje připojení svazku v Dockeru. Konfigurace DATA_* v DLQ vymezuje povolená umístění a služba vůči nim kontroluje požadované výstupní adresáře.
Obě nastavení musí souhlasit: Docker musí úložiště připojit a DLQ musí znát povolenou cestu uvnitř kontejneru. Samotná hodnota DATA_* svazek Dockeru nevytvoří. Ze stejné konfigurace vznikají předvolené složky v API a webovém rozhraní. To se hodí na Unraidu, kde může mít jeden kontejner připojeno několik různých úložišť.
Webové rozhraní zpříjemňuje práci s frontou mimo terminál. Nabízí hromadné přidávání odkazů, procházení složek, oblíbené cíle, seskupené úlohy, nastavení za běhu i záznamy událostí. Obě rozhraní pracují se stejnou frontou: odkazy přidám přes SSH a později je zkontroluju z telefonu.
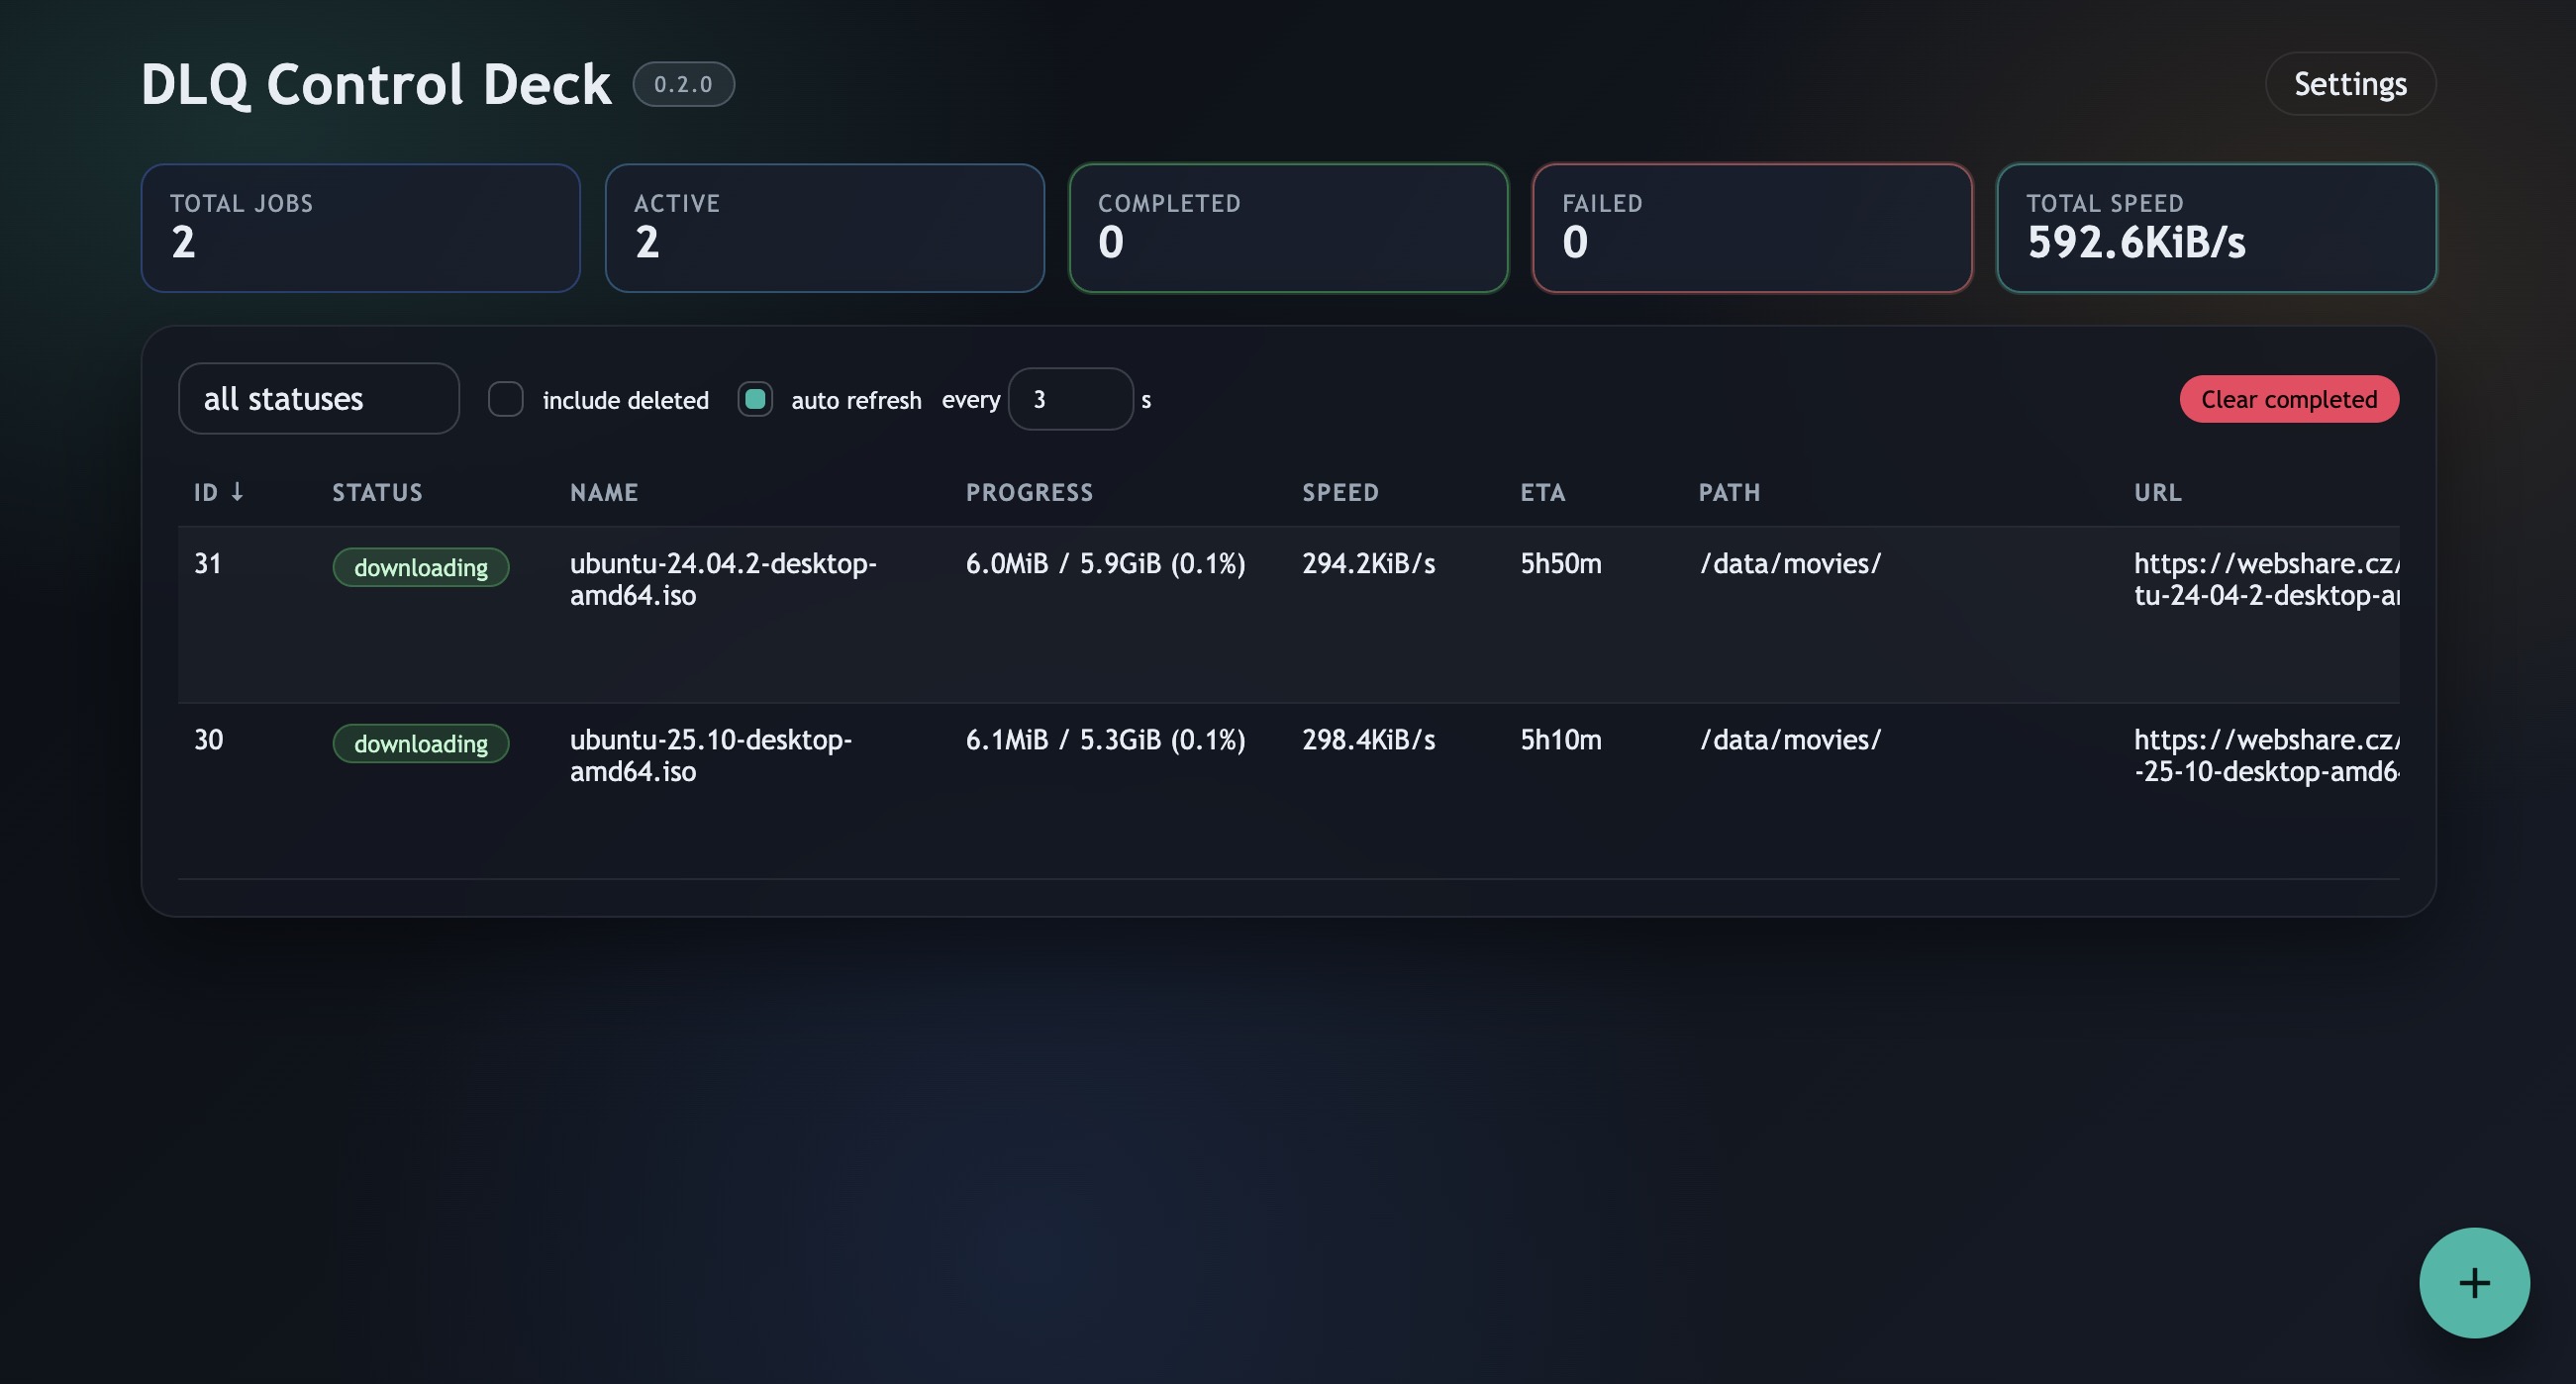
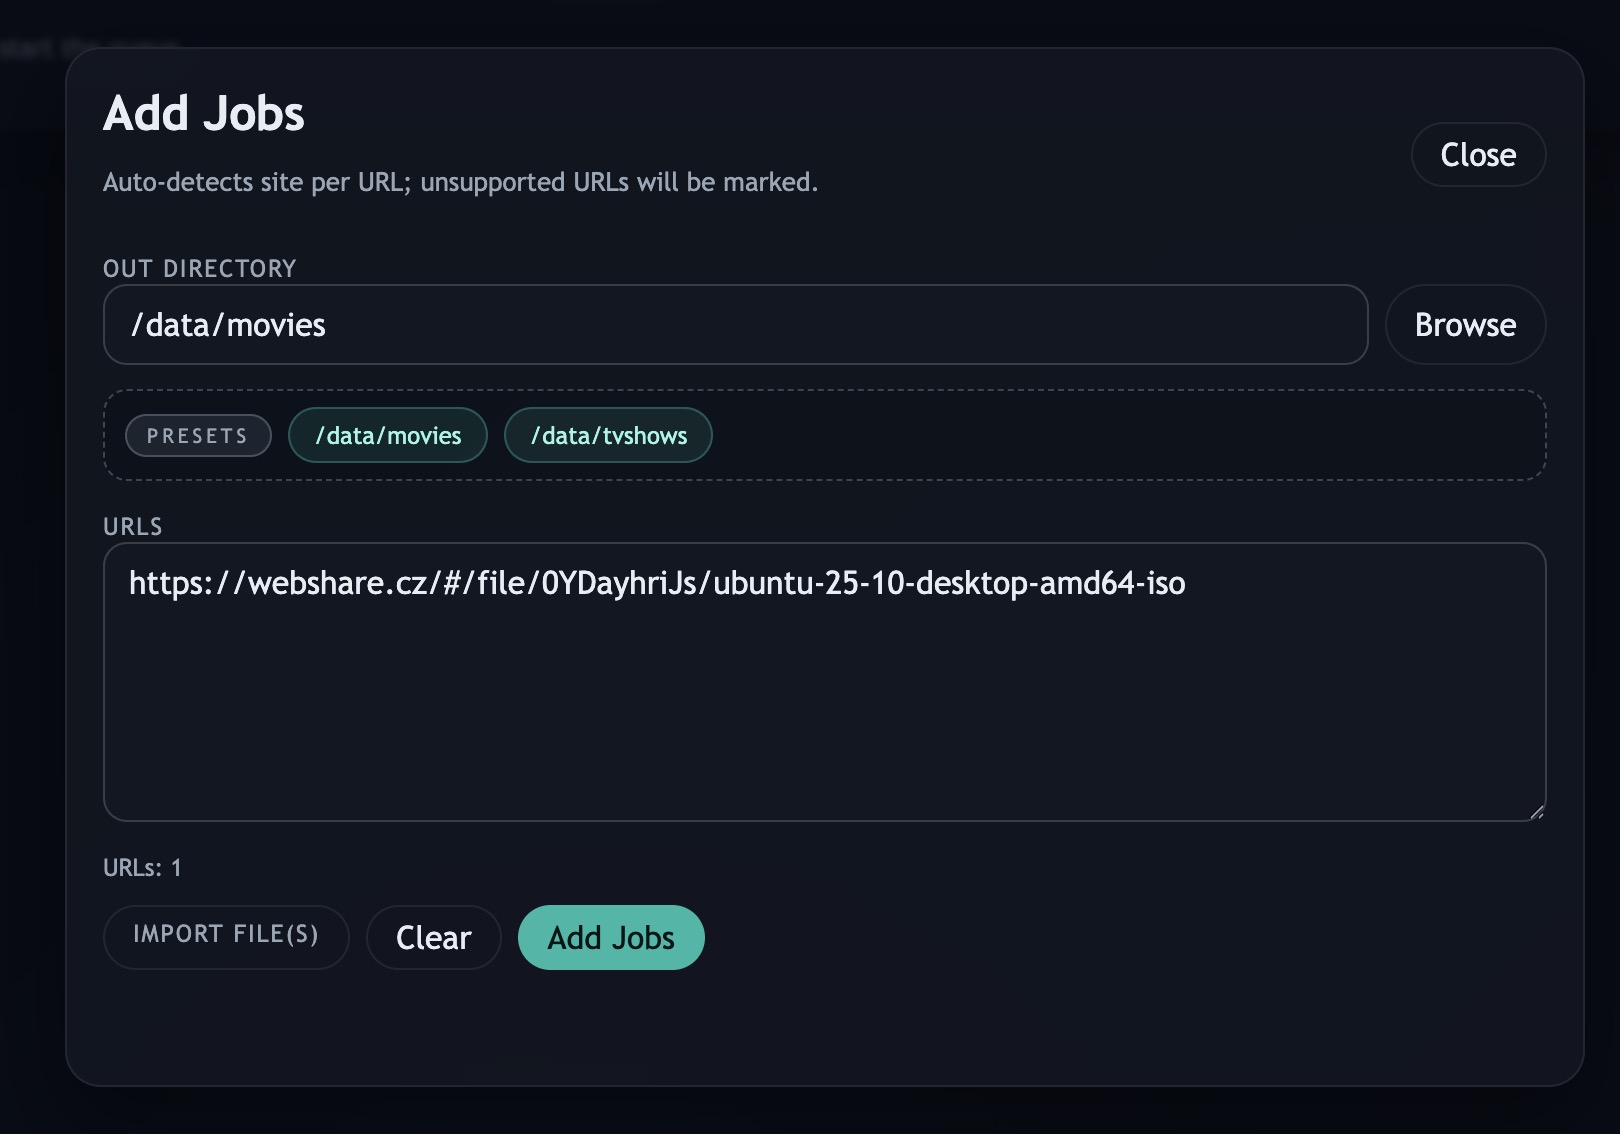
DLQ je určené pro důvěryhodnou domácí síť nebo síť Dockeru. HTTP API nemá ověřování přístupu. Vzdálený přístup proto potřebuje vstupní bod s přihlášením, například reverzní proxy, a zablokovaný přímý přístup k samotné službě. Pokud by byla chráněná jen webová stránka a API zůstalo veřejně dostupné, k frontě by se stále mohl dostat kdokoli. RPC rozhraní aria2 má vlastní nastavení ARIA2_SECRET; toto heslo nechrání HTTP API služby DLQ.
Co mi projekt přinesl
První verze byla služba na pozadí, příkazový řádek, SQLite, aria2 a resolver pro Webshare. Další funkce vyplynuly z používání: webové rozhraní pro telefon, podpora MEGA, rozbalování archivů, seskupování jejich dílů, oblíbené složky a nastavení, které můžu měnit bez nového sestavování kontejneru.
V Go jsem si vyzkoušel HTTP službu, souběžné zpracování úloh a klienta pro příkazový řádek. Ve SvelteKitu jsem kolem služby postavil jednoduchý přehled. Díky tomu, že frontu spravuje hlavní služba, mohlo webové rozhraní zůstat volitelné i s přibývajícími funkcemi.
Výsledek odpovídá tomu, co jsem potřeboval. Přidám odkazy, zavřu terminál a později se vrátím k frontě, ve které dohledám, co se stalo. Vzdálenou plochu už k tomu nepotřebuju.